wtorek, 17 września 2013

Hurtownie danych w Oracle: Star Transforation

Star Transformation


Star Transformation jest metodą łączenia tabel używaną w środowiskach hurtowni danych w celu podniesienia wydajności wykonywania zapytań. Ta metoda zastępuje tradycyjne sposoby łączenia tabel : nested loops, sort merge join i hash join. Metoda Star Transformation jest dostępna od wersji 8i Oracle.
Schemat „Star”

Schemat gwiazdy jest najprostszym schematem hurtowni danych. Nazwa pochodzi od konstrukcji samego schematu, przypomina ona nieco kształt gwiazdy. W tym schemacie mamy jedną tabelę faktu , stanowiącą centralny element schematu, oraz przynajmniej dwie tabele wymiarów będące rozszerzeniami tabeli faktu.


W przypadku wykonania zapytania korzystającego z takich tabel, przeprowadzone zostanie łączenie każdej z tabel rozszerzeń z tabelą faktu. Tabele nie łączą się między sobą. Na powyższej ilustracji tabelę faktu stanowi tabela „zamówienia” , natomiast tabele rozszerzeń (wymiarów) stanowią wszystkie pozostałe.


Schemat „Snowflake”


W bazach danych możemy się spotkać również ze schematami typu „Snowflake”, które są rozwinięciem schematu „Star”. 


Star Query

Ideą Star Transformation jest zmniejszenie ilości full table skanów dużych tabelach – w tym przypadku na tabeli faktu – sales. W typowych zapytaniach na strukturze gwiazdy duża tabela faktu jest łączona z wielokrotnie mniejszymi tabelami rozszerzeń. Tabela faktu ma zazwyczaj po jednym kluczu obcym dla każdej tabeli rozszerzenia.

select ch.channel_class,cu.cust_city,t.calendar_year,sum(s.amount_sold) suma_sprzedazy
from
sales s,channels ch,customers cu, times t where
s.time_id=t.time_id and ch.channel_id=s.channel_id
and s.cust_id=cu.cust_id
and channel_class in ('Direct','Internet')
and cust_state_province='CA' and t.calendar_year ='1998'
group by ch.channel_class,cu.cust_city,t.calendar_year;


Bez stosowania Star Transformation, łączenie przebiega w taki sposób, że tabela faktu (w tym przypadku tabela Sales) jest łączona osobno z każdą z tabel. Mimo, że w efekcie końcowym zapytania zostanie wyświetlona bardzo nieznaczna część tabeli sales, przeprowadzany jest na niej full scan. Im większa jest tabela faktu, tym większa utrata wydajności. Przyjrzyjmy się sposobowi wykonania tego zapytania w „tradycyjny” sposób:


Tabela zawiera prawie milion wierszy:


Sam wynik zapytania dotyczy jednak jedynie 11 wierszy. Oczywiście wymagane było połączenie tabeli sales z tabelami channels,times i customers, jednak wykonywanie w tym celu full scana jest bardzo nieefektywne.


Star Transformation

Optymalizator kosztowy rozpoznaje takie struktury i stosuje dla zapytań na nich specjalnie zoptymalizowane plany wykonania przy użyciu metody Star Transformation. Aby jednak było to możliwe, musi zostać spełnione kilka warunków:


  • na kluczach obcych tabeli faktu powinny zostać założone indeksy bitmapowe. W tym przypadku osobne indeksy bitmapowe powinny zostaćzałożone na kolumnach: channel_id,time_id,cust_id tabeli sales.
  • Parametr STAR_TRANSFORMATION_ENABLED musi być włączony dla sesji lub bazy danych.
  • Muszą być przynajmniej dwie tabele wymiarów i jedna tabela faktu.
  • Statystyki wszystkich obiektów biorących udział w zapytaniu muszą być świeże.


Kiedy te warunki będą spełnione, optymalizator kosztowy będzie automatycznie wybierał metodę Star Transformation która jest bardzo efektywna dla zapytań typu star query (tj. takich jak omawiane wcześniej). Dla użytkownika fakt zmiany metody wykonywania zapytania jest niezauważalny (poza przyspieszeniem :) ). Zastosowanie Star Transformation nigdy nie doprowadzi do odmiennych niż pierwotne wyników zapytania.

Sposób działania Star Transformation

W jaki sposób działa metoda Star Transformation? Przebiega zasadniczo w dwóch fazach.
W pierwszej fazie, system stosuje filtry na tabeli rozszerzeń i określa wartości klucza głownego dla wybranych wierszy. W drugiej fazie mając już ograniczone dane z tabeli rozszerzenia, system przeszukuje indeksy bitmapowe założone na kluczach obcych tabeli faktu w celu wybrania tylko niezbędnych wierszy z tabeli faktu.


Przeprowadzimy teraz testy. Włączam parametr star_transformation_enabled dla sesji i ponawiam generowanie planu wykonania dla tego samego zapytania:

alter session set star_transformation_enabled=true;


select ch.channel_class,cu.cust_city,t.calendar_year,sum(s.amount_sold) suma_sprzedazy
from sales s,channels ch,customers cu, times t where
s.time_id=t.time_id and ch.channel_id=s.channel_id
and s.cust_id=cu.cust_id and channel_class in ('Direct','Internet')
and cust_state_province='CA' and t.calendar_year ='1998'
group by ch.channel_class,cu.cust_city,t.calendar_year;
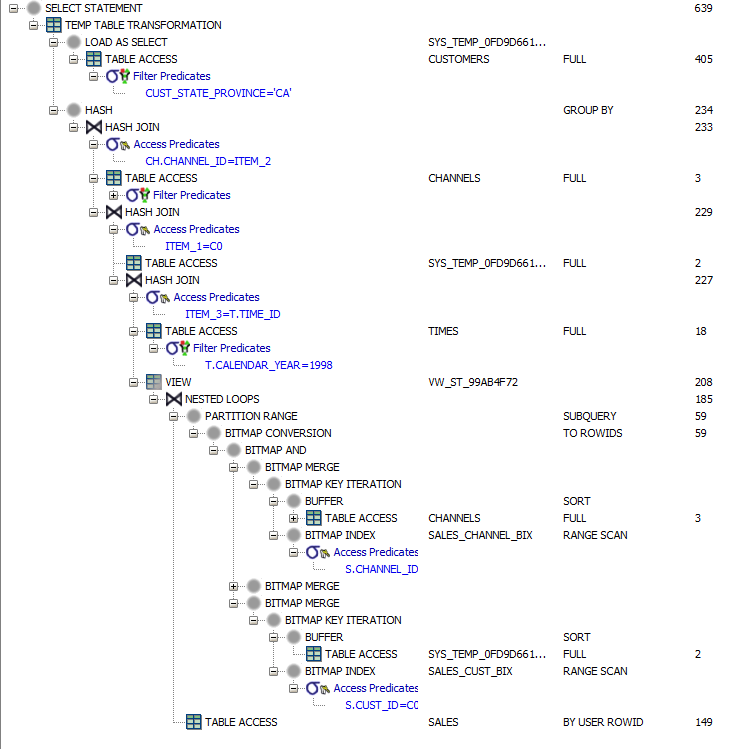


Róznica polega przede wszystkim na sposobie dostępu do danych z tabeli faktu:


Porównajmy z wcześniejszym sposobem dostępu:


Należy pamiętać, że im większa jest tabela faktu , tym większy koszt generuje full table scan. Wynika to z większej ilości danych które trzeba odczytać. Im więc tabela faktu jest większa, tym bardziej opłacalna z punktu widzenia optymalizacji jest implementacja metody Star Transformation.
Podczas wykorzystania metody Star Transformation, następuje dwukrotny dostęp do tabel rozszerzeń. Po jednym razie dla każdej z dwóch faz wykonywania tej metody. Jeśli optymalizator kosztowy uzna to za opłacalne z punktu opłacalności, system utworzy tabelę tymczasową zawierającą odfiltrowane dane i będzie z niej korzystał zamiast wielokrotnego dostępu do tabeli rozszerzenia.


Testy były przeprowadzane na schemacie SH , który jest dostarczany jako schemat przykładowy razem z samą bazą. Wystarczy jedynie odblokować konto SH i ustawić mu hasło.


piątek, 13 września 2013

Wyrażenie CASE w SQL (IF THEN ELSE tylko w SQL)

Wyrażenie CASE zapewnia funkcjonalność konstrukcji typu IF-THEN-ELSE w SQL.
Wynik wyrażenia CASE może być m.in. uzależniony od wartości w jednej kolumnie :

select last_name, department_id,
case department_id
when 90 then 'Zarząd'
when 60 then 'Geeki informatyczne'
else 'Inni'
end case

from employees;


W powyższym przykładzie jeśli w kolumnie department_id pojawi się wartość 90, case zwróci nam ciąg tekstowy „Zarząd”, jeśli pojawi się wartość 60 dostaniemy tekst „Geeki informatyczne”. W przypadku pojawienia się dowolnej innej wartości otrzymamy tekst „Inni”. Po wszystkich warunkach musi być zakończenie konstrukcji klauzulą „END CASE” lub samo „END”. 

Klauzula „else” nie jest konieczna. W przypadku pojawienia się innej niż 60 lub 90 wartości, dostaniemy NULL.


Na powyższym obrazku widzimy też użycie aliasu dla wyrażenia CASE. Aby można było użyć aliasu, warunki musimy zakończyć klauzulą „END”. W przypadku zastosowania klauzuli „END CASE” dostajemy błąd.


CASE nie musi opierać się na wartościach z jednej kolumny. Na poniższym przykładzie pokazuję dodanie kolumny z opisem stanowiska uzależnionym od wartości w różnych kolumnach.

select last_name, salary,department_id,manager_id, case
when manager_id is null then 'Prezes'
when department_id=90 then 'Czlonek zarządu'
when department_id=60 and salary>5000 then 'Programista Oracle :)'
when department_id=100 then 'Ci co nie chcą dać podwyżek'
else 'jacyś inni' end stanowisko
from employees;


Case działa w taki sposób, że jeśli warunek okaże się prawdziwy, nie sprawdza następnych. Widać to na przykładzie pracownika „King”. Pracuje w departamencie 90 i jednocześnie ma null w manager_id. Wyświetla się przy nim „Prezes” a nie „Członek zarządu”, ponieważ warunek pierwszy został spełniony (null w manager_id) i system nie sprawdzał kolejnego.

poniedziałek, 9 września 2013

Oracle SQL Tuning Advisor


SQL Tuning Advisor


W miejsce ręcznej optymalizacji zapytań SQL, można zastosować rozwiązania automatycznej optymalizacji dostarczane przez Oracle. Jednym z takich narzędzi jest SQL Tuning Advisor wprowadzony w Oracle 10g. Optymalizator kosztowy może działać w dwóch trybach:
  • Normal mode
  • Tuning mode


Normal Mode
Podczas zwykłego funkcjonowania, optymalizator kosztowy generuje dla zapytań plany wykonania. W tym trybie optymalizator ma narzucone ścisłe ograniczenia czasowe na działanie, zazwyczaj są to ułamki sekund. W tym czasie musi stworzyć jak najlepszy plan wykonania zapytania.


Tuning Mode
W trybie strojenia optymalizator wykonuje dodatkową analizę mającą na celu sprawdzenie czy plan wykonania zapytania wygenerowany w zwykłym trybie funkcjonowania można jeszcze ulepszyć. Wynikiem działania takiej dodatkowej analizy nie jest plan wykonania zapytania, a szereg proponowanych działań wraz z ich uzasadnieniem i szacowanymi korzyściami. Wywołany w trybie strojenia optymalizator nazywamy ATO (Automatic Tuning Optimizer). W trybie strojenia optymalizator może poświęcić nawet kilka minut na optymalizację zapytania. Ponieważ taka analiza również pochłania zasoby systemowe, ATO jest przeznaczony do wykorzystania dla złożonych i bardzo obciążających zapytań mających duże znaczenie dla całego systemu. Tryb strojenia jest włączany przez użytkownika dla wybranych przez niego zapytań.


Automatic Database Diagnostic Monitor (ADDM)
Poczynając od Oracle 10g, identyfikacją najbardziej obciążających system zapytań zajmuje się ADDM. Najbardziej obciążające zapytania to te zużywające najwięcej zasobów CPU, I/O i przestrzeni tymczasowej. Takie obciążające zapytania są dobrymi kandydatami do optymalizacji przez SQL Tuning Advisor. Otrzymuje on na wejściu zapytania wskazane przez ADDM i tworzy dla nich wskazówki optymalizacyjne wraz z uzasadnieniem, szacunkowymi korzyściami płynącymi z ich zastosowania i jeśli jest dostępna – komendą która wdroży daną wskazówkę (np. komendę tworzącą odpowiedni indeks). Użytkownik może akceptować wskazówki Advisor'a i w ten sposób optymalizować zapytania.


Sposób działania SQL Tuning Advisor'a
SQL Tuning Advisor jest jedynie kontrolerem procesu optymalizacji. Wywołuje on ATO (Optymalizator kosztowy działający w trybie strojenia) aby ten przeprowadził poniższe analizy:


  • Analiza statystyk. ATO sprawdza obiekty biorące udział w zapytaniu pod kątem aktualności statystyk. Jeśli statystyki nie są aktualne, tworzy wskazówkę dotyczącą ich odświeżenia. Wykorzystując próbkowanie zbiera również dodatkowe informacje w celu dostarczenia brakujących lub niepoprawnych statystyk na wypadek gdyby wskazówki Advisor'a nie zostały zaimplementowane.
  • Profilowanie SQL. Profil dla zapytania SQL jest tym , czym statystyki dla tabel. Bazując na kolejnych wykonaniach danego zapytania, ATO zbiera informacje na temat sposobu wykonania, i dzięki temu może lepiej dobrać podpowiedzi dla niego. Weryfikuje czy jego własne szacunki dotyczące wykonania zapytania pokrywają się z rzeczywistością. Profile SQL są formą indywidualnych dla zapytania informacji, statystyk i ustawień optymalizatora. ATO buduje profil zapytania SQL i sugeruje utworzenie go dla danego zapytania. Kiedy profil zostanie stworzony, będzie stosowany przez optymalizator kosztowy do tworzenia efektywniejszych planów wykonania danego zapytania w normalnym trybie działania optymalizatora. Dla użytkownika fakt korzystania z profilu SQL jest niezauważalny. Podczas budowania profilu, ATO testuje swoje własne wskazówki poprzez szacowanie obciążenia z nowymi ustawieniami, ale też częściowe realne wykonanie zapytania z użyciem nowych konfiguracji.
  • Analiza ścieżek dostępu. ATO analizuje ścieżki dostępu w zapytaniu, i jeśli stworzenie indeksu poprawiłoby wydajność zapytania, rekomenduje jego utworzenie.
  • Analiza struktury zapytania. Niekiedy sama struktura zapytania powoduje niską wydajność. W takich przypadkach ATO sugeruje zmianę zapytania. Wykrywa np. łączenia kartezjańskie, czy stosowanie UNION tam gdzie powinno się użyć UNION ALL.


Źródła zapytań podlegających optymalizacji przez ATO


Zapytania które będą analizowane i optymalizowane przez ATO mogą pochodzić z trzech źródeł:
  • najbardziej obciążające zapytania zidentyfikowane przez ADDM
  • zapytania SQL które znajdują się w cache'u
  • wybrane zapytania podane przez użytkownika
W przypadku zapytać pochodzących z cache, lub zakwalifikowanych przez ADDM, użytkownik ma możliwość wybrania niektórych zapytań. Nie ma konieczności optymalizacji wszystkich.


Sposób użycia SQL Tuning Advisor'a


Aby przejść do STA, logujemy się do Enterprise Manager'a. Następnie klikamy link „Advisor Central” dostępny na dole strony:


Następnie wybieramy „SQL Advisors” w górnej lewej części strony:


Dalej wybieramy SQL Tuning Advisor:


Mamy tutaj możliwość wyboru źródła pochodzenia zapytań które mają podlegać optymalizacji:


Zapytania najbardziej obciążające


Po wyborze „Top Activity” na poprzednim ekranie, zobaczymy wykres obciążenia bazy na przestrzeni czasu, pod kątem zużycia różnego rodzaju zasobów.


W lewej dolnej części strony możemy wybrać spośród tych najbardziej obciążających, zapytania które chcemy optymalizować. Niekiedy tabela pozostaje pusta. Wystarczy wtedy odświeżyć stronę. Możemy podejrzeć treść zapytań klikając na link w kolumnie SQL ID:


Zaznaczamy je, upewniamy się że w selektorze „Actions” wybrane jest „Schedule SQL Tuning Advisor” i naciskamy „Go”:


Pojawi nam się ekran który służy do uruchomienia analizy i optymalizacji wybranego zapytania.


Mamy możliwość wybrania typu analizy spośród dwóch opcji:


  • Limited. Jeśli wybierzemy tę opcję, nie zostanie utworzony profil SQL, ale za to analiza przebiega bardzo szybko.
  • Comprehensive. Wykonywana jest pełna analiza, tworzony jest też profil SQL dla zapytania. Taki rodzaj analizy trwa jednak znacznie dłużej niż w przypadku opcji „Limited”.


Możemy też określić limit czasowy na analizę wszystkich wybranych do optymalizacji zapytań ( w oknie „Total Time Limit”), oraz limit jednostkowy dla pojedynczego zapytania. Niżej, w sekcji Schedule możemy wybrać czy analiza ma się rozpocząć teraz, czy też chcemy ją odłożyć na nieco później (np. wtedy kiedy baza będzie mniej eksploatowana). Po zatwierdzeniu przyciskiem „Submit” (znajdującym się w prawym górnym rogu), zobaczymy taki oto ekran:

Przez parę chwil, ATO będzie analizował nasze zapytania. Gdy skończy, zobaczymy listę proponowanych działań:


Dla niektórych podpowiedzi optymalizacyjnych będzie dodana opcja implementacji. O ile np. do podpowiedzi dotyczącej stworzenia indeksów czy odświeżenia statystyk ATO jest w stanie wygenerować komendę która od razu to wykona, o tyle do podpowiedzi np. dotyczących zmiany kształtu zapytania nie będzie to możliwe.
W prawym górnym rogu mamy przycisk „Show SQL”, który pozwoli nam podejrzeć treść komendy którą ATO nam sugeruje:


Wybrałem jedną z podpowiedzi i kliknąłem „Implement”. System przeszedł do okna umożliwiającego zastosowanie wskazówki – w tym przypadku odświeżenia statystyk tabel. Mamy tutaj też możliwość zastosowania wskazówki teraz, lub w innym terminie.


Przeprowadziłem jeszcze jeden test, tym razem wybierając nieco więcej zapytań. Proces analizy też trwał już dłużej.


Po zakończeniu pojawił się ekran z podsumowaniem statystyk analizy. Wybieram przycisk „Show all results”:


Przejdziemy wtedy do ekranu z propozycjami ATO:


Analiza zapytań historycznych


Przy użyciu ATO mamy też możliwość analizowania historycznych zapytań. Tym razem po przejściu do SQL Tuning Advisora link „Historical SQL”:


Zobaczymy listę zapytań które nadal rezydują w cache kursorowym. Mamy tam informacje o zapytaniach jako takich, ale też dane na temat czasu wykonywania zapytania, ilość wykonań danego zapytania etc.


Podobnie jak wcześniej, zaznaczam zapytania które chcę poddać analizie, po czym wybieram przycisk „schedule SQL Tuning Advisor”:


Tak jak i wcześniej przechodzę przez widok w którym określam rodzaj analizy i moment jej przeprowadzenia:


Na kolejnym ekranie wybieram „Show all results”:


i przechodzę do ekranu podpowiedzi, gdzie zaznaczam wybrane zapytanie i klikam „View Recomendations” aby zobaczyć podpowiedzi dla danego zapytania:


Należy traktować podpowiedzi ATO troszkę z dystansem, ponieważ jest to tylko program , a program nie myśli w taki sposób jak człowiek. Nigdy też człowieka nie zastąpi. Nie traktujmy więc wszystkich podpowiedzi bezkrytycznie i weryfikujmy czy jego sugestie są racjonalne. Pamiętajmy też, że ATO nie wymyśli też wszystkiego co wymyślić może człowiek. Nie raz więc będzie się zdarzać że po ATO trzeba będzie poprawiać :)

środa, 28 sierpnia 2013

Indeksy bitmapowe łączeniowe


Indeksy bitmapowe łączeniowe są wykorzystywane głównie w hurtowniach danych, często wraz z Star Transformation. Indeksy łączeniowe pojawiły się z wersją 9i Oracle.
Takie indeksy pozwalają zmniejszyć ilość wykonywanych kosztownych operacji łączenia tabel. Taki indeks będzie przechowywał wcześniej wyliczone wyniki łączenia. Podczas zapytania z użyciem łączenia, będzie można użyć danych z indeksu, zamiast wykonywać operację łączenia.
W indeksach bitmapowych każda unikalna wartość w kolumnie jest powiązana z mapą bitową, w której każdy bit reprezentuje jeden wiersz w tabeli. 1 oznacza że wartość występuje w danym wierszu, 0 że nie występuje. Indeksy takie zakłada się na kolumnach o małym zróżnicowaniu. Nie powinno się ich stosować na tabelach często modyfikowanych (tzn. na tabelach w których pojawiają się często nowe wiersze, kasowane są stare, lub zmienia się wartość kolumny na której założony jest taki indeks). Wiąże się to z obciążeniem wynikającym z konieczności aktualizacji takiego indeksu.

Przyjrzyjmy się teraz praktycznemu zastosowaniu tego typu indeksów. Pracujemy na schemacie SH , który jest schematem przykładowym dostarczanym przy instalacji bazy. Wystarczy ten schemat odblokować. Sprawdźmy plan wykonania zapytania wymagającego łączenia tabel customers i sales. Większość obciążenia generowane jest przez obciążenia wynikającego z samego łączenia, lub operacji z łączeniem związanych:


select count(*) from sales join customers using(cust_id) where cust_city='Yokohama';


Założymy teraz indeks bitmapowy łączeniowy i porównamy wyniki. Najprostszy taki indeks mógłby zawierać samo tylko złączenie:


create bitmap index lacz1 on sales(c.cust_id)
from sales s , customers c
where s.cust_id=c.cust_id local;

Słowo local na końcu jest wymagane wyłącznie w przypadku tabel partycjonowanych. W tym jednak przypadku stosujemy warunek na kolumnie cust_city, więc najlepiej byłoby gdyby ta kolumna również znalazła się w indeksie. W innym wypadku, w związku koniecznością dostępu do danych z tej kolumny, CBO decydowałby o nie używaniu naszego nowego indeksu. Stworzymy więc indeks zawierający nie tylko łączenie, ale również kolumnę cust_city z tabeli customers:


create bitmap index lacz1 on sales(customers.cust_city)
from sales , customers
where sales.cust_id=customers.cust_id local;

Gdybyśmy dostali komunikat o braku klucza głównego , należy uruchomić poniższe polecenie:

alter table customers enable constraint customers_pk;

Dotyczy to jednak jedynie powyższego przykładu w schemacie SH. Indeksy bitmapowe łączeniowe wymagają, by łączenie następowało z użyciem klucza głównego, a ten w tabeli curstomers istnieje, ale jest wyłączony. Porównajmy teraz plany wykonania zapytania i ich koszty:


Znacznie mniejszy koszt wykonania tego zapytania z użyciem indeksu bitmapowego łączeniowego, wynika z faktu, że nie ma konieczności wykonywania łączenia ze sobą tabel i związanych z tym odczytów danych które są do tego potrzebne. Informacje o połączeniu są przechowywane w indeksie. Oczywiście w przypadku np. dodania wiersza do tabeli sales, trzeba będzie znaleźć wszystkie odpowiedniki po stronie drugiej tabeli i zaktualizować indeks. To wiąże się z generowaniem sporego obciążenia przy ładowaniu danych.
Weźmy teraz troszkę bardziej skomplikowany przypadek. Łączymy ze sobą trzy tabele liniowo, przy czym warunek filtrowania wierszy stosujemy na ostatniej.


select count(*) from sales join customers using(cust_id)
join countries using (country_id) where country_name='Poland';


Ponownie pojawia nam się spore obciążenie wynikające z potrzeby łączenia tabel. Tworzę więc indeks bitmapowy łączeniowy, tym razem na łączeniu ze sobą trzech tabel:

create bitmap index lacz2 on sales(countries.country_name)
from sales , customers, countries
where sales.cust_id=customers.cust_id
and customers.country_id=countries.country_id
local;

Sprawdźmy jak prezentuje się nam plan wykonania teraz:


Ograniczenia indeksów bitmapowych łączeniowych

  • nie da się założyć takiego indeksu na tabeli tymczasowej , ani tabeli typu IOT.
  • W klauzuli FROM nie można wymienić tej samej tabeli dwukrotnie
  • nie może to być indeks funkcyjny


wtorek, 27 sierpnia 2013

Wyłączanie ACL w Oracle 11g

Jak całkiem wyłączyć ACL w Oracle 11g? Metoda znaleziona w internetach, może się komuś też przyda:


begin
 begin
 dbms_network_acl_admin.drop_acl(
 acl => 'all-network-PUBLIC.xml'
 );
 exception
 when others then null;
 end;
 dbms_network_acl_admin.create_acl(
 acl => 'all-network-PUBLIC.xml',
 description => 'Network connects for all',
 principal => 'PUBLIC',
 is_grant => true,
 privilege => 'connect'
 );
 DBMS_NETWORK_ACL_ADMIN.ADD_PRIVILEGE(
 acl => 'all-network-PUBLIC.xml',
 principal => 'PUBLIC',
 is_grant => true,
 privilege => 'resolve'
 );
 dbms_network_acl_admin.assign_acl(
 acl => 'all-network-PUBLIC.xml',
 host => '*'
 );
 end;
 /
 commit;